
В статистике и машинном обучении байесовские методы хорошо известны, хотя хемометристы сталкиваются с ними крайне редко. Теорема Байеса была впервые разработана английским священником Томасом Байесом в 1700-х годах, однако он так и не опубликовал теорему, основанную на его методе, и первое описание было сделано Ричардом Прайсом на основе заметок, сделанных после смерти Байеса.
Аннотация
Концепции байесовского анализа вводятся путем обсуждения матрицы смешения 2 × 2 с неравными объемами выборки для каждого класса.
Байесовские методы могут быть представлены самыми разными способами. Теорема Байеса (также называемая правилом Байеса или законом Байеса) — это простое математическое уравнение (которое, как мы увидим, может быть выражено по-разному).
Байесовские методы не нашли широкого применения в хемометрии, вероятно, из-за алгоритмического, а не статистического, происхождения этой дисциплины, поскольку в 1970-х годах хемометрия отделилась от статистики.
МАТРИЦА СМЕШЕНИЯ
Рассмотрим простой эксперимент, в котором мы разрабатываем тест на то, болен ли донор определенным заболеванием.
- Нам удается протестировать 80 контрольных (здоровых) доноров, но только 20 больных доноров. Матрица путаницы представлена в таблице 1.
- Теперь мы хотим оценить, насколько хорошо работает тест.
- Точность теста для здоровых доноров составляет 72/76 = 0,947. То есть почти 95% тех тестов, которые говорят, что донор здоров, верныТочность2 теста для здоровых доноров составляет 72/76 = 0,947. То есть, почти 95% тестов, утверждающих, что донор здоров, являются правильными.
- Для больных доноров это значение равно 16/24 = 0,667, что не кажется таким уж большим. В нашей матрице данных только 16 из 24 доноров, у которых было диагностировано заболевание, были правильно идентифицированы.
ТАБЛИЦА 1. Результаты тестирования здоровой популяции размером в 80 человек и больной популяции размером в 20
| Актуально | |||
|---|---|---|---|
| Здоровый | Больной | ||
| Предсказанный | Здоровый | 72 | 4 |
| Больной | 8 | 16 |
НЕРАВНЫЕ РАЗМЕРЫ
Однако слабым местом является то, что мы использовали разное количество здоровых и больных доноров, возможно, потому, что было трудно найти столько же больных субъектов, тогда набрать большую контрольную группу было нетрудно: ограничение, которое, безусловно, не редкость.
РАВНЫЕ РАЗМЕРЫ
Способ решить эту проблему — представить, что две группы имеют одинаковый размер.
- В таблице 2 мы масштабируем каждый столбец до равного общего значения (на этот раз 1, но это может быть любое число, например, 100).
- Теперь мы обнаруживаем, что точность теста для здоровых доноров составляет 0,9 / 1,1 = 0,818, а не 0,947, тогда как для больных доноров — 0,8 / 0,9 = 0,889, а не 0,667.
ТАБЛИЦА 2. Данные из таблицы 1, где каждый столбец был масштабирован до равного общего значения
| Актуально | |||
|---|---|---|---|
| Здоровый | Больной | ||
| Предсказанный | Здоровый | 0.9 | 0.2 |
| Больной | 0.1 | 0.8 |
АПРИОРНАЯ ВЕРОЯТНОСТЬ
Что является правильным? Однозначного ответа нет, но большинство людей, использующих байесовские подходы, скажут, что это зависит от наших предположений об априорной вероятности того, что человек болен. В данных таблицы 1 мы предполагаем, что априорная вероятность того, что человек болен, равна доле больных доноров, что является субъективным предположением и может быть сделано на основе интуиции при отсутствии каких-либо предварительных экспериментальных данных. Это вполне может произойти, если доноры из таблицы 1 были типичными пациентами, поступившими в больницу с похожими симптомами. В случае с таблицей 2 мы предполагаем, что каждый, кого мы тестируем, имеет априорную вероятность заболевания 0,5. Однако мы можем захотеть провести тестирование только тех пациентов, чей врач считает их больными, и поэтому вероятность того, что донор болен до проведения тестирования, может составлять 0,9, если врач хорошо отбирает потенциально больных пациентов для тестирования.
Байесовский анализ использует определенную априорную вероятность перед анализом результатов теста. В таблице 3 представлены три различные априорные вероятности. Общий итог каждой таблицы случайностей теперь равен 1, а столбцы масштабируются до вероятностей любого из четырех исходов, предполагающих априорную вероятность принадлежности образца к одному из двух классов.
- Когда априорные вероятности равны относительным числам выборок, точность каждого класса равна 0,947 и 0,667, а общая точность (сумма диагональных элементов) равна 0,72 + 0,16 = 0,88, то есть 88% выборок будут правильно отнесены к их соответствующему классу.
- Когда они оба равны 0,5, точность каждого класса равна 0,818 и 0,889, а общая точность равна 0,85.
- Когда априорная вероятность быть здоровым равна 0,1, а быть больным — 0,9 (как может случиться, если клиника отбирает только лиц, у которых, по их подозрению, есть заболевание), точность каждого класса становится 0,333 и 0,986, а общая точность равна 0,81.
ТАБЛИЦА 3. Байесовский подход к данным таблицы 2, с тремя различными априорным вероятностями
| Актуально | Актуально | Актуально | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Априорн. вероятность | 0.8 | 0.2 | 0.5 | 0.5 | 0.1 | 0.9 | ||||||
| A | B | PRE | A | B | PRE | A | B | PRE | ||||
| Предсказанный | A | 0.72 | 0.04 | 0.947 | A | 0.45 | 0.1 | 0.818 | A | 0.09 | 0.18 | 0.333 |
| B | 0.08 | 0.16 | 0.667 | B | 0.05 | 0.4 | 0.889 | B | 0.01 | 0.72 | 0.986 | |
- Сокращения: A = здоровый; B = больной; PRE = точность, или апостериорная вероятность в байесовской терминологии.
АПОСТЕРИОРНАЯ ВЕРОЯТНОСТЬ
В большинстве байесовских анализов мы не часто используем слово «точность» и вместо этого используем термин «апостериорная вероятность».
- Если, например, априорная вероятность того, что образец принадлежит к классу здоровых, равна 0,1, а к классу больных — 0,9, поскольку далее анализируются только подозрительные больные образцы, то:
- Если тест предполагает, что образец получен от здорового человека, апостериорная вероятность того, что человек здоров, равна 0,333, а болен — 0,667.
- Если тест предполагает, что образец получен от больного человека, апостериорная вероятность того, что человек болен, равна 0,986, а здоров — 0,014.
- С практической точки зрения, если образец от подозреваемого больного индивида поступает в лабораторию, мы проводим тест и обнаруживаем, что он по-прежнему относится к классу больных, то вероятность того, что он болен, увеличивается с 0,9 до 0,986, тогда как если он теперь относится к классу здоровых, то вероятность того, что он болен, уменьшается с 0,9 до 0,667, поскольку лабораторный тест противоречит первоначальной клинической оценке.
- С практической точки зрения, если врач считает, что пациент болен, но тест показывает, что образец может происходить от здорового пациента, включая это последнее доказательство, это все еще учитывает диагноз врача, поскольку он обычно прав в 90% случаев, но делает его менее уверенным в своей правоте.
Каждый эксперимент изменяет вероятность, поэтому, если есть три или четыре теста, и все они указывают в одном направлении, вероятность принадлежности к определенному классу становится очень высокой. Апостериорная вероятность одного эксперимента или теста становится априорной вероятностью следующего, когда имеется несколько тестов. Мы можем, конечно, оставить это как отдельный тест.
В задачах с одиночной классификацией возникает дилемма относительно того, что использовать в качестве априорной вероятности, поскольку наши относительные размеры выборки не обязательно могут отражать вероятность того, что выборка является членом определенного класса, но в первую очередь обусловлены экспериментальным ограничением. По умолчанию, конечно, априорные вероятности равны относительным размерам выборки. Для методов, обладающих высокой точностью классификации, это может не иметь большого значения, но при значительном перекрытии распределений с соответственно относительно высокой долей неправильно классифицированных выборок корректировка предшествующих вероятностей может иметь довольно серьезный эффект.
ТЕОРЕМА БАЙЕСА
Приведенные выше вычисления также могут быть сформулированы с использованием теоремы Байеса, которая имеет несколько основных выражений. Наиболее распространенным является следующий.
Апостериорная вероятность принадлежности к определенному классу = (априорная вероятность того, что они являются членами определенного класса × вероятность того, что они правильно отнесены к этому классу) / (вероятность того, что они отнесены к этому классу)
- Для класса больных людей и третьего примера в таблице 3
- Априорная вероятность = 0,9
- Вероятность того, что они назначены правильно = 0,72 / 0,9 = 0,8
- Вероятность того, что они отнесены к этому классу = 0,73 (сумма строк 2)
- Следовательно, апостериорная вероятность равна 0,9 × 0,8 / 0,73 = 0,986, как рассчитано выше.
- Уравнение может быть выражено немного более формально с помощью
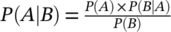 где
- P(A | B) — апостериорная вероятность того, что образец является членом нашей группы (событие A), учитывая, что тест положительный для этой группы (событие B), где A | B подразумевает, что событие A происходит, если событие B происходит;
- P(A) — априорная вероятность того, что образец является членом группы (= 0,9 в нашем примере);
- P(B| A) — вероятность положительного результата теста, если образец является членом группы (= 0,8 в нашем примере);
- P(B) — вероятность положительного результата теста образца (по всем группам) (= 0,73 в нашем примере).
- На практике P(A) может оцениваться на основе субъективного суждения до эксперимента, иногда дополняемого предыдущими тестами.
- P(B | A) и P(B) взяты из нашей матрицы путаницы или обучающего набора.
АЛЬТЕРНАТИВНЫЕ ФОРМЫ ТЕОРЕМЫ БАЙЕСА
Существуют другие формы уравнения.
- Более простым уравнением является P(A | B) = P(A ∩ B) / P(B), где ∩ подразумевает, что происходят оба события.
- В нашем случае P(A ∩ B) = 0,72 для больных индивидуумов, то есть доли индивидуумов, которые одновременно имеют заболевание и проходят тестирование как таковые, если предварительная вероятность равна 0,9.
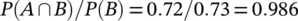
- Вычисления выглядят простыми, поскольку матрица смешения нормализована, поэтому все элементы суммируются до 1, но так представляются такие данные не всегда, и поэтому не каждый раз все так просто.
- В нашем случае P(A ∩ B) = 0,72 для больных индивидуумов, то есть доли индивидуумов, которые одновременно имеют заболевание и проходят тестирование как таковые, если предварительная вероятность равна 0,9.
- Другое уравнение, которое можно использовать, это
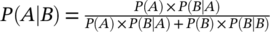 , и мы оставим читателю возможность проверить и убедиться в этом.
РАСПРОСТРАНЕННОСТЬ И ОШИБКИ ТИПА 1 И ТИПА 2
Мы также можем выразить апостериорную вероятность в терминах ошибок 1-го и 2-го типов и распространенности. В этом случае мы можем использовать исходную матрицу смешения, и априорная вероятность численно совпадает с распространенностью.
- Вернитесь к таблице 1. Обозначьте больных людей как положительный класс.
- Частота ошибок FPR или типа 1, α = 8/80 = 0,1.
- FNR или частота ошибок 2-го типа, β = 4/20 = 0,2.
- Теперь мы используем априорную вероятность в качестве оценки распространенности. Для второго примера таблицы 3, T = 0,5. Это, конечно, будет отличаться в зависимости от нашей оценки априорных.
- Теперь мы вычисляем α(1 − T) + (1 − β) T = p+ = 0.1 × 0.5 + 0.8 × 0.5 = 0.45 в нашем случае.
- Апостериорная вероятность того, что образец, который тестируется как больной, на самом деле болен, теперь определяется как (1 − β) T /p+ = 0.8 × 0.5/0.45 = 0.889.
Фактически, большинство различных показателей, обсуждаемых в литературе, могут быть скорректированы с помощью байесовских априорных значений. Байесовские уравнения могут быть расширены там, где имеется более двух групп, и вводиться в самых разных обстоятельствах, но мы ограничимся в этой статье обсуждением простой матрицы смешения 2 × 2 или таблицы сопряженности.
ЧАСТОТНИКИ
Байесовские методы не находят широкого применения в хемометрии, вероятно, из-за алгоритмического, а не статистического происхождения этой дисциплины, поскольку в 1970-х годах хемометрия отделилась от статистики. Однако те люди, которые верят в байесовские подходы, считают эти методы единственным логическим подходом к вычислению вероятностей. Альтернативная философия принадлежит частотникам, которые не верят, что вероятности являются самостоятельным параметром, обладающим собственными правами. В этой статье нет места для подробного обсуждения этого раскола, однако математические формулировки правила Байеса не зависят от философии пользователя. Априорные вероятности могут просто относиться к частоте, с которой определенная группа присутствует в выборке населения, а не к вере пользователя в априорные вероятности. Термин “преобладание”, скорее будет использоваться частотником, а термин “априорная вероятность” — байесовцем, но мы показываем, что они численно эквивалентны.